中华书局 中华经典古籍库
《中华经典古籍库》是大型古籍整理本数据库,由中华书局-古联(北京)数字传媒科技有限公司出品,收录资源涵盖经、史、子、集各部,完整保留注释、校勘、专名等整理成果,文本准确,内容权威,提供多维度的检索功能和多元化的阅读方式。目前已收录包括中华书局在内的多家合作机构的古籍整理图书10,900余种,约30亿字。
了解本系统的主要功能与使用方法
全球汉籍影像开放集成(简称“典津”)是第一个全过程AI驱动的古籍数字资源聚合基础设施,其早期版本(版本0.1)发布于2023年10月,历经多次迭代,全新的AI驱动版于2025年12月上线。LOGO标志书法由本中心主任刘石教授题写。
典津系统后端的数据聚合、加工、对齐、抽取、编目、利用各环节均采用AI大模型多智能体驱动实现,并遵循标准OpenAI、Anthropic协议。目前正在使用的模型主要有:
典津系统前端界面主要面向用户提供检索和浏览服务,其功能介绍如下。

① 数据源:可在此对检索范围进行限定(详见⑤至⑧)。如不限定,则默认检索所有数据源。
② 检索词:可在此输入要检索的任意关键词,如书名、作者、版本等。系统会自动实现异体、简繁、新旧字形的兼容检索。
③ 检索选项:可在此进行高级检索设置(详见⑨至⑩)。如不设置,则执行默认设置。
④ 检索按钮:点击此按钮发起检索并获取结果。
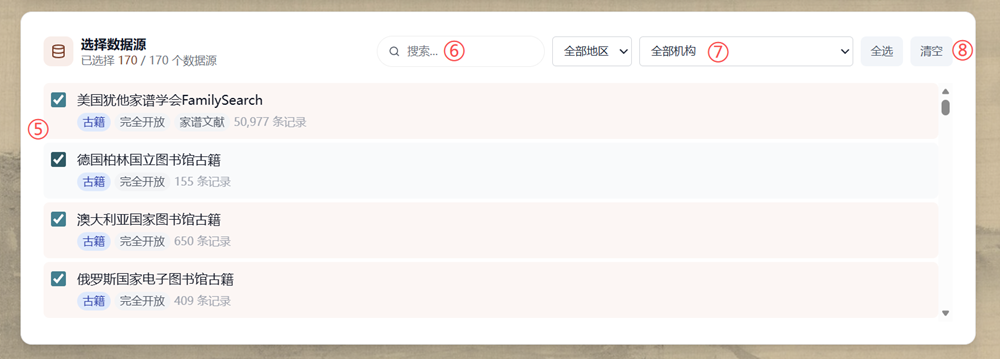
⑤ 数据源手动勾选:可手动在此进行数据源的选中、取消选中操作。
⑥ 数据源搜索:可在此输入关键词直接寻找数据源。
⑦ 数据源筛选:可在此按照国家/地区名称、机构名称筛选数据源。
⑧ 数据源自动勾选:可在此对数据源进行全选、清除全选等操作。建议在执行数据源搜索或筛选之后再进行本项操作。
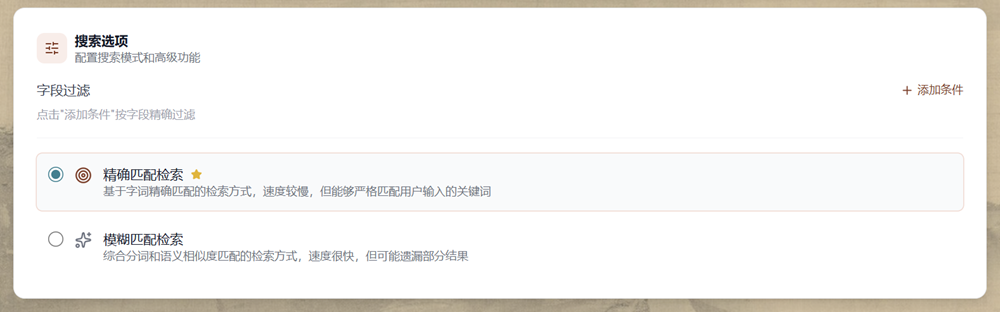
⑨ 精确匹配检索:基于字词精确匹配的检索方式,速度较慢,但能够严格匹配用户输入的关键词。
⑩ 模糊匹配检索:综合分词和语义相似度匹配的检索方式,速度很快,但可能遗漏部分结果。
注意:语义相似度采用向量匹配,例如检索“吃饭”可命中《饮膳正要》等古籍。
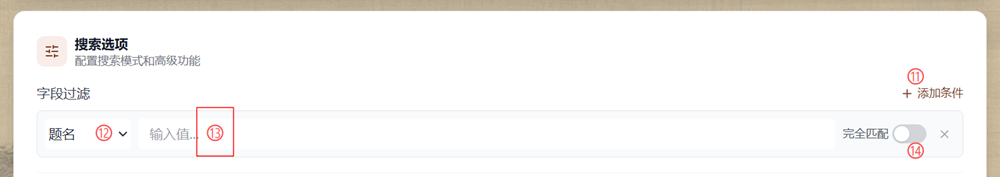
⑪ 添加条件:点击此按钮开启字段过滤功能。
⑫ 字段选择:选择想要过滤的字段,如“题名”。
⑬ 过滤关键词:可在此输入要过滤的关键词,此设置须与“字段选择”搭配生效。
⑭ 匹配模式:可在此选择字段过滤的匹配模式,开启后实行“完全匹配”(慎用),不开启则默认实行“包含匹配”。
系统支持用户注册,注册后提供收藏夹、浏览记录查看、API申请等进阶功能。
注意:未注册用户可以正常使用系统的各项检索、查看等功能。
即《全球汉籍AI智能分类目录》,又名《典津·AI艺文志》,是史上首个AI编订古籍版本目录,基于全球汉籍版本循证AI智能体自动生成。
该目录的智能体编目工作保持长期动态化运行,故目录内容也随时处于变动状态。
注意:AI智能体尚无法做到100%准确,系统已提供置信度参考值,请注意分辨。
可进入本团队目前正在运维的专题性影像数据库。
作为数字人文基础设施,典津系统允许用户通过API机制开展通讯。用户注册登录后可在后台申请API密钥(需管理员审核),利用密钥开展API交互。具体使用方法详见API文档(按此查阅)。
请注意:请大家共同维护公益性基础设施的运行环境。若有滥用API导致系统正常运行受到影响的,管理员将视情节程度采取密钥封禁、账户封禁、IP地址封禁、IP段封禁等措施。
了解典津 – 全球汉籍影像开放集成团队
“清华大学-同方知网数字人文联合研究中心”成立于2025年3月29日,由清华大学与同方知网数字科技有限公司共建。
中心依托清华大学深厚的人文积淀、扎实的工科基础以及同方知网的知识资源整合与技术转化优势,致力于以数字技术赋能传统文化研究,携手建立知识共享和数字评价的新模式。
刘石(1963-),四川大邑人,清华大学教授,人文学院院长。全国古籍整理出版规划领导小组成员,国家社科基金重大项目“基于大数据技术的古代文学经典文本分析与研究”首席专家。
研究方向主要为中国古代文学和古典文献,著有《有高楼杂稿》《法书要录校理》《诗画之间》等,合作主编《续修四库全书总目提要》。